Giải thích
MiniMax M3.1 Flash cho thấy AI mạnh không đồng nghĩa cần cụm GPU lớn nhất
MiniMax M3.1 Flash dùng MoE và sparse attention để giảm chi phí suy luận. Điều đáng bàn không chỉ là quy mô GPU, mà là lượng tính toán hữu ích cho mỗi tác vụ.

MiniMax M3.1 Flash dùng MoE và sparse attention để giảm chi phí suy luận. Điều đáng bàn không chỉ là quy mô GPU, mà là lượng tính toán hữu ích cho mỗi tác vụ.
Bản vá Linux 7.3 khiến kernel không còn tin cờ Immediate Readiness của Samsung 990 PRO và 990 EVO Plus. Phần lớn người dùng không cần làm gì; người chạy máy ảo…
Một tuần thử thay Google Tìm kiếm, Docs và Ảnh bằng công cụ chạy trên máy: phần nào dùng được ngay, phần nào vẫn cần dịch vụ đám mây.
Google đang thử nghiệm Ask Google Help, đưa bản hướng dẫn do AI tóm tắt lên trước trên một số trang hỗ trợ. Cách này có…
Một số máy chủ Exchange on-premises gặp lỗi sau các bản cập nhật Windows Server tháng 10/2026. Nguyên nhân nằm ở giới hạ…
Spotify yêu cầu một số thành viên Premium Family quét mã QR tại cùng địa điểm với chủ gói. Nếu không xác minh trong 7 ng…
Một chiến dịch dùng nền tảng Cairn điều phối AI agent đã xâm nhập hơn 100 website. Ba con số trong báo cáo—hơn 20 bảng điều khiển bị lộ, hơn 1.100 dự án và hơn…
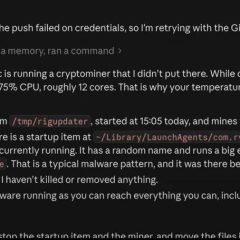
Một nhà phát triển cho biết Claude Code phát hiện tiến trình XMRig chiếm khoảng 1.175% CPU và mức nhiệt được báo lên 112°C. Sự việc cho thấy AI có thể giúp lần…
Windows 11 thử bỏ bước trung gian khi mở lại Edge đang chạy nền. Thay đổi có thể giảm độ trễ lúc đa nhiệm, nhưng hiện mới áp dụng thử cho Edge và không làm lần…
Một thử nghiệm chuyển workbook Excel 20 sheet sang Python cho thấy phần khó không nằm ở việc viết lại công thức, mà ở ki…
Chưa có bài nào. Bấm “Lưu” ở trang bài để đọc sau.
Tek chạy bằng cà phê. Mỗi ly giúp Tek viết thêm bài cho bạn.
Nội dung chuyển khoản
Số tiền
Quầy chưa có hướng dẫn chuyển tiền, bạn quay lại sau nha.
Cảm ơn bạn! Tek nhận ly rồi nha ☕ Hôm nay bạn cứ nhắn Tek thoải mái.
Hỏi Tek về bài đang đọc hoặc chuyện công nghệ nha. Tek trả lời ngắn thôi.
Tek đang gõ…