Tóm tắt nhanh
- TradeMAV đang gây quỹ hub RAMDeck với giá ưu đãi 109 USD, hướng tới việc tận dụng RAM và VRAM trên nhiều thiết bị để chạy AI cục bộ.
- Hệ thống chia các lớp của mô hình sang từng máy qua mạng; nó không biến RAM rời rạc thành bộ nhớ phần cứng thống nhất.
- Trong thử nghiệm do hãng công bố, cụm có năm máy đăng ký chạy gpt-oss-120b đạt 3,1 token/giây, mất khoảng bảy phút khởi tạo; một máy chỉ ở chế độ chờ.
- Nền tảng RPC có thể tự dựng bằng llama.cpp miễn phí, nhưng kho mã RAMDeck công khai không phải toàn bộ sản phẩm và có hạn chế giấy phép thương mại.
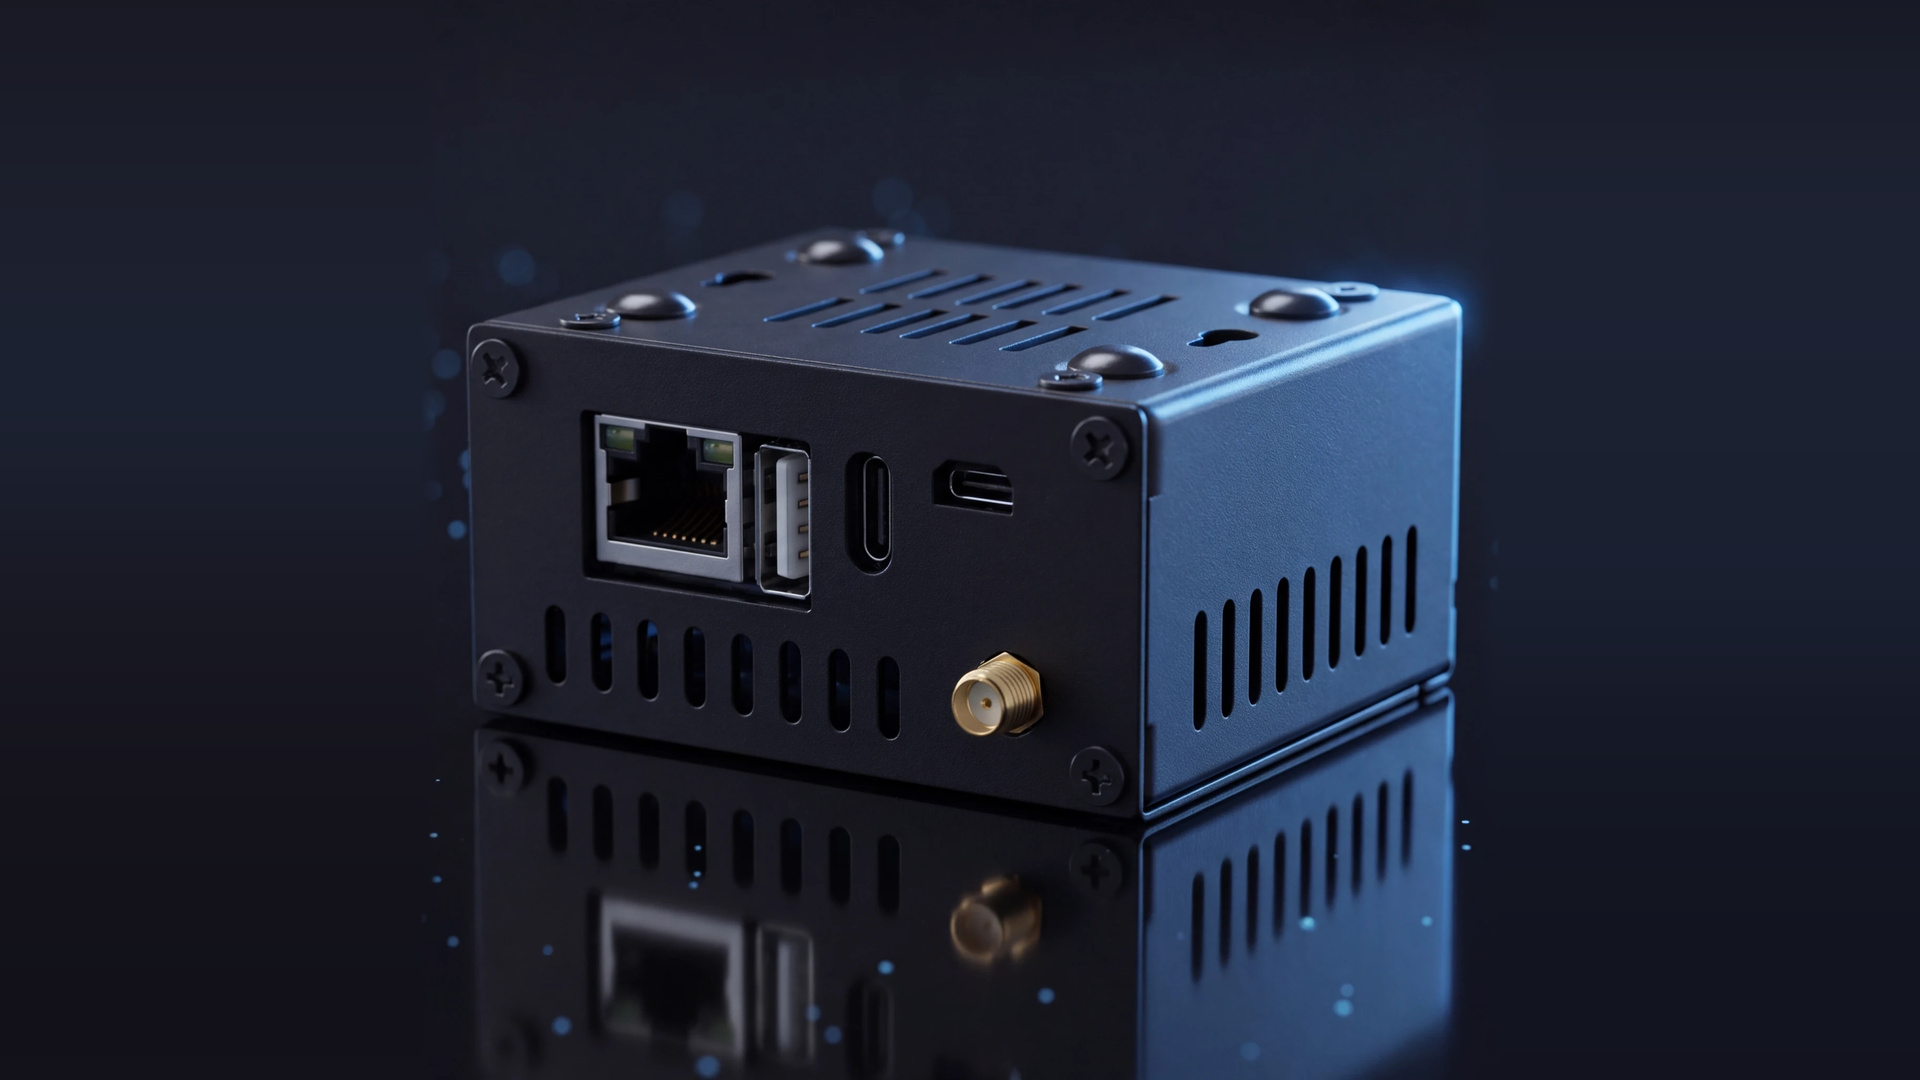
RAMDeck của TradeMAV đang gây quỹ trên Indiegogo với lời hứa tận dụng những máy tính sẵn có để nạp mô hình AI lớn hơn khả năng bộ nhớ của từng máy. Mức 109 USD là giá ưu đãi cho người ủng hộ sớm, không phải giá một bộ tăng tốc có sẵn GPU hay lượng RAM lớn đi kèm.
Điểm đáng cân nhắc nằm ở chữ “chạy được”: một mô hình không còn báo thiếu bộ nhớ vẫn có thể trả lời rất chậm. Vì vậy, RAMDeck nên được nhìn như công cụ điều phối phần cứng khác loại, thay vì cách mua thêm hiệu năng với giá rẻ.
RAM được tận dụng nhờ chia việc, không phải ghép thành một thanh nhớ lớn
RAMDeck giải quyết giới hạn dung lượng bằng cách để mỗi thiết bị giữ và tính toán một phần mô hình. Kết quả trung gian được chuyển sang máy tiếp theo qua mạng nội bộ, còn trọng số của từng phần nằm trong bộ nhớ cục bộ của máy phụ trách. Đây là khác biệt quan trọng so với việc CPU hoặc GPU truy cập trực tiếp một vùng nhớ chung trên cùng bo mạch.
Trong kho ramdeck-core-public, TradeMAV mô tả phần mềm chạy trên máy thành viên sẽ khởi động ggml-rpc-server của llama.cpp, dùng cổng 50052 cho GPU và 50053 cho CPU. Một bộ điều phối tương thích có thể gửi công việc qua giao thức RPC chuẩn của llama.cpp. Nói cách khác, cơ chế suy luận từ xa bên dưới không đòi hỏi phải sở hữu chiếc hub của hãng.
Cách tổ chức này phù hợp khi mô hình không vừa bộ nhớ của một thiết bị, nhưng không tự động biến mọi máy cũ thành tài nguyên hữu ích ngang nhau. Phần chạy trên CPU chậm vẫn phải hoàn thành trước khi luồng tính toán liên quan đi tiếp; truyền dữ liệu qua mạng cũng phát sinh thời gian chờ. Chỉ nhìn tổng dung lượng RAM trên màn hình rồi suy ra tốc độ sẽ dễ dẫn đến kỳ vọng sai.
TradeMAV cho biết bộ điều phối ưu tiên phần cứng nhanh trước, đưa trọng số vào CUDA VRAM hoặc bộ nhớ dùng cho Metal trên Apple Silicon, sau đó mới dùng thêm RAM hệ thống. Quy tắc này hợp lý hơn việc chia đều dữ liệu: máy yếu chỉ nên tham gia khi lượng bộ nhớ nó bổ sung đủ cần thiết để chấp nhận phần thời gian xử lý tăng thêm.
Ví dụ rõ nhất nằm ngay trong cấu hình thử nghiệm của hãng. Laptop Acer có mặt trong danh sách thành viên nhưng được để chờ, vì những thiết bị nhanh hơn đã chứa đủ mô hình. “Có năm máy trong cụm” vì thế không đồng nghĩa cả năm máy đều tính toán, càng không đồng nghĩa thêm một laptop nữa sẽ khiến AI trả lời nhanh hơn.
Con số token mỗi giây chỉ có nghĩa khi đi cùng mô hình và cấu hình
Các kết quả RAMDeck công bố cần được đọc như những cấu hình riêng biệt, không phải các nấc hiệu năng của cùng một phép thử. Kiến trúc mô hình, phần cứng giữ trọng số và phần công việc thực sự giao cho GPU đều có thể làm tốc độ thay đổi lớn.
Trong hướng dẫn Linux của TradeMAV, cụm thử gpt-oss-120b dùng mạng Gigabit LAN và có các thành viên dưới đây. Điểm cần chú ý là vai trò thực sự của từng thành viên, thay vì chỉ cộng số máy đã kết nối.
| Thiết bị trong thử nghiệm TradeMAV | Bộ xử lý | Vai trò trong lần chạy |
|---|---|---|
| Máy Windows điều phối | CPU AMD Ryzen và RTX 3060 | Điều phối; tính toán bằng GPU và CPU |
| Mac mini M4 | Apple M4 | Tính toán qua Metal |
| MacBook M3 | Apple M3 | Tính toán qua Metal |
| Máy Linux Ubuntu | Ryzen 7 6800H | Nhận phần mô hình còn lại, tính toán qua CPU |
| Laptop Acer | Core i5 hai nhân | Ở chế độ chờ, không nhận lớp mô hình |
Cấu hình: TradeMAV, hướng dẫn cụm Linux.
Với mô hình gpt-oss-120b có phần trọng số lớn hơn 60 GB, TradeMAV công bố mất khoảng bảy phút khởi tạo và sinh văn bản liên tục ở mức 3,1 token/giây trên cụm này. Đây là kết quả tự công bố của hãng, không phải phép đo độc lập hay lời bảo đảm tốc độ cho một bộ máy khác.
Những demo khác của TradeMAV cho thấy độ chênh đáng kể. Bảng dưới giữ riêng các cấu hình để tránh hiểu rằng chỉ cần tăng số máy là tăng tốc.
| Phép thử | Qwen3-Coder 30B | Qwen3-Coder-Next REAP 40B | Mô hình 7B |
|---|---|---|---|
| Tốc độ sinh văn bản (token/giây; cao hơn tốt hơn) | 39 | 16 | 43 |
| Điều kiện được nguồn nêu | Mini PC có RTX 3060 và Mac mini M4 | Demo dùng mini PC có RTX 3060; nguồn không nêu đầy đủ từng máy | Chạy trên RTX 3060, không chứng minh tăng tốc nhờ nhiều máy |
Số liệu: các demo TradeMAV được TechRadar tổng hợp. Hai mô hình Qwen là dạng hỗn hợp chuyên gia, chỉ kích hoạt một phần tham số mỗi token; các cột không phải phép so sánh trực tiếp trên cấu hình giống nhau.
| Phép thử | Mô hình dense 27B | gpt-oss-120b, cụm sáu thiết bị | gpt-oss-120b, cụm năm máy đăng ký |
|---|---|---|---|
| Tốc độ sinh văn bản (token/giây; cao hơn tốt hơn) | 1,92 | 1,37 | 3,1 |
| Điều kiện được công bố | Bốn thiết bị; nguồn không nêu đầy đủ cấu hình | Sáu thiết bị; nguồn không nêu đầy đủ cấu hình | Cấu hình TradeMAV trong bảng trên; laptop Acer không nhận lớp mô hình |
| Thời gian khởi tạo | — | — | Khoảng bảy phút |
Số liệu: TradeMAV, các demo và hướng dẫn Linux. Không đủ điều kiện thử giống nhau để xác định cấu hình nào hiệu quả hơn.
Khoảng cách giữa các kết quả cho thấy tổng số tham số chưa đủ để dự đoán tốc độ. Cũng không thể quy toàn bộ thời gian chờ cho mạng Ethernet: phần tính toán trên CPU, cách chia lớp và đặc tính mô hình đều có thể ảnh hưởng, trong khi các số liệu công bố chưa tách riêng từng nguyên nhân.
Ở mức vài token mỗi giây, việc chờ một câu trả lời dài sẽ khác hẳn trải nghiệm hội thoại có phản hồi nhanh. Lợi ích dễ thấy hơn là khả năng hoàn thành một tác vụ vốn không nạp được trên máy đơn, nếu người dùng chấp nhận chờ. Đó là đổi tốc độ lấy dung lượng, không phải bằng chứng nhiều máy cũ sẽ thay được một GPU có đủ VRAM.
Người dùng Việt Nam nên thử nhu cầu trước khi bỏ tiền mua hub
Khoản chi cho RAMDeck chỉ hợp lý nếu phần điều phối giúp giảm đủ công cài đặt và vận hành. TradeMAV quảng bá khả năng tự phát hiện thiết bị, phân lớp, phục hồi khi có lỗi, bảng điều khiển và API tương thích OpenAI. Đây mới là phần tiện dụng mà hãng cần chứng minh, bởi chức năng nhận công việc RPC đã tồn tại trong llama.cpp.
Người quen dòng lệnh có thể thử phương án RPC của llama.cpp trên phần cứng đang có trước khi quyết định mua hub. Còn việc tải kho RAMDeck công khai không đồng nghĩa nhận được đầy đủ trải nghiệm thương mại: README gọi đây là bản tham chiếu của một hệ mã lớn hơn, ở phiên bản trước 1.0, không kèm giao diện hay bảng điều khiển.
Giấy phép cũng cần được đọc đúng. TradeMAV ghi rõ mã RAMDeck là dạng công khai mã nguồn để xem và sử dụng, nhưng không được OSI công nhận là mã nguồn mở; Apache 2.0 được bổ sung Commons Clause hạn chế bán lại thương mại nếu không có giấy phép riêng. Không nên đánh đồng giấy phép của sản phẩm này với phần nền llama.cpp.
Phạm vi hỗ trợ còn có chỗ chưa khớp: trang hướng dẫn của hãng quảng bá Linux và mô tả gói cài cùng dịch vụ systemd, trong khi README kho tham chiếu lại ghi chưa hỗ trợ Linux cho node agent. Hai tài liệu có thể nói về những bản phân phối khác nhau, nhưng người định tự cài không nên coi chúng là cam kết tương đương. Bản cài cho sản phẩm và mã tham chiếu cần được phân biệt ngay từ đầu.
Với người mua tại Việt Nam, mức 109 USD hiện là khoản ủng hộ ưu đãi trên nền tảng gây quỹ quốc tế, không phải giá bán lẻ trong nước. Chưa có mức giá Việt Nam được xác minh; không nên quy đổi riêng giá gây quỹ rồi coi đó là tổng chi phí nhận hàng. TechRadar nêu chiến dịch có mục tiêu cố định 10.000 USD, dự kiến kết thúc ngày 8/11/2026, đồng thời cho biết các trang hãng mà họ kiểm tra chưa liệt kê bộ xử lý, bộ nhớ, thông số cổng kết nối hay công suất tiêu thụ của hub.
Vì vậy, lựa chọn thận trọng là thử mô hình thực sự cần dùng trên số máy sẵn có, kiểm tra thời gian chờ có chấp nhận được hay không rồi mới cân nhắc trả tiền cho sự tiện lợi. Với nhu cầu trò chuyện nhanh, một mô hình nhỏ chạy vừa máy có thể phù hợp hơn mô hình lớn phải chia sang nhiều thiết bị. Còn nếu muốn ủng hộ RAMDeck, cần tính cả rủi ro trễ hẹn hoặc không giao được hàng của phần cứng gây quỹ, thay vì xem lời hứa điều phối là một sản phẩm đã hoàn thiện.
Nguồn tham khảo: Hướng dẫn Linux và thử nghiệm cụm máy của TradeMAV; RAMDeck Core Engine trên GitHub; TechRadar.