Tóm tắt nhanh
- Rubin HPC là GPU chuyên dụng cho mô phỏng và xử lý dữ liệu khoa học, thuộc nền tảng NVIDIA Vera Rubin.
- Mỗi GPU có hơn 50.000 nhân CUDA; GeForce RTX 5090 có 21.760 nhân, nhưng chênh lệch này không nói lên hiệu năng chơi game.
- NVIDIA tích hợp tăng tốc dữ liệu thưa và NVLink thế hệ thứ 7 để phục vụ các hệ thống nhiều GPU.
- Sản phẩm dự kiến có mặt trên các hệ thống triển khai từ năm 2028; giá bán lẻ tại Việt Nam chưa được công bố.
NVIDIA công bố Rubin HPC tại hội nghị siêu máy tính SC26, với hơn 50.000 nhân CUDA trên một GPU. Con số này cao hơn đáng kể so với 21.760 nhân của GeForce RTX 5090, nhưng hai sản phẩm phục vụ những công việc khác nhau: Rubin HPC nhắm đến mô phỏng khoa học và phân tích dữ liệu, không phải chơi game hay đồ họa máy tính để bàn.
GPU này thuộc nền tảng Vera Rubin, được thiết kế cho các luồng mô phỏng trong khoa học, kỹ thuật và phân tích. NVIDIA dự kiến Rubin HPC sẽ có mặt trên các hệ thống vào năm 2028. Hiện chưa có giá bán lẻ tại Việt Nam, cũng chưa có thông số benchmark thực tế để so sánh hiệu năng.
Số nhân CUDA nhiều hơn không biến Rubin HPC thành RTX 5090 kế nhiệm
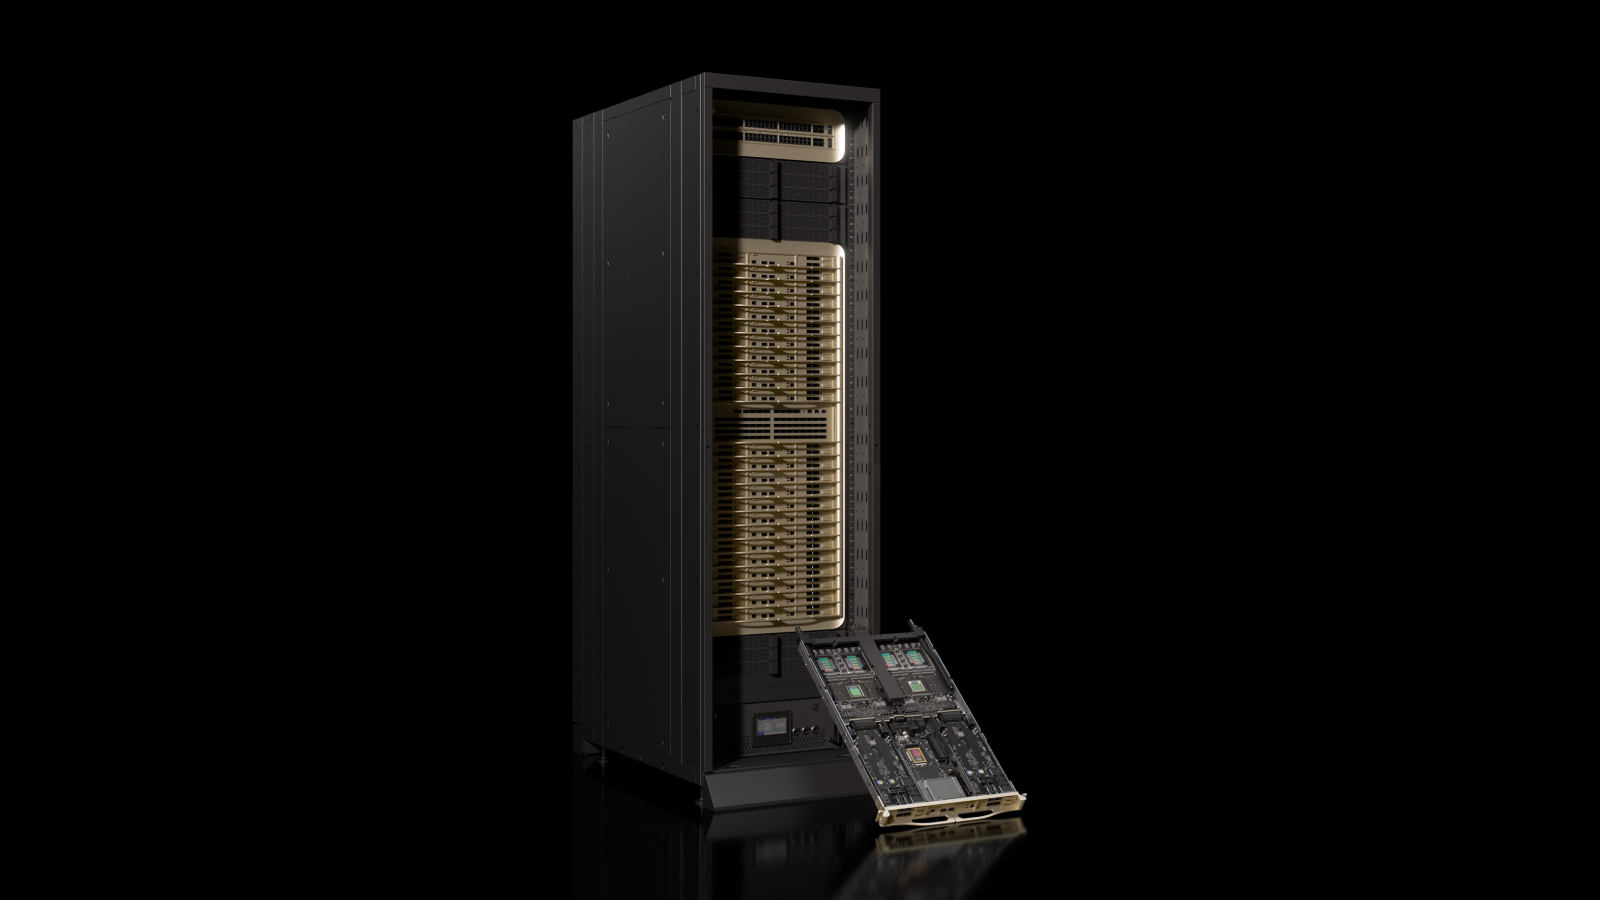
Rubin HPC có hơn 50.000 nhân CUDA trên một GPU, trong khi GeForce RTX 5090 có 21.760 nhân. Phép so sánh này cho thấy quy mô phần cứng tính toán của Rubin HPC, chứ không phải mức tăng tốc trong game: NVIDIA thiết kế chip cho mô phỏng và xử lý dữ liệu, còn RTX 5090 thuộc dòng đồ họa tiêu dùng.
Số nhân chỉ là một phần của hiệu năng. Kết quả còn phụ thuộc vào kiến trúc, băng thông bộ nhớ, khả năng cấp dữ liệu cho bộ xử lý và cách phần mềm khai thác phần cứng. NVIDIA chưa công bố benchmark hay thông số băng thông của Rubin HPC, nên chưa thể suy ra nó nhanh hơn RTX 5090 bao nhiêu lần trong bất kỳ tác vụ nào. Nhiều nhân hơn cũng không có nghĩa người dùng có thể lắp GPU này vào PC chơi game thông thường.
Rubin HPC tập trung giữ dữ liệu luân chuyển cùng nhịp với phép tính
Trong mô phỏng khoa học, GPU thường phải lấy một lượng nhỏ dữ liệu từ các tập dữ liệu rất lớn rồi lặp phép tính trên quy mô rộng. Nếu dữ liệu không đến kịp, các đơn vị tính toán phải chờ; tăng số nhân đơn thuần sẽ không giải quyết được nút thắt đó.
NVIDIA cho biết Rubin HPC kết hợp số nhân CUDA lớn với khả năng tăng tốc dữ liệu thưa (sparse data acceleration), nhằm cung cấp dữ liệu cho các nhân khi chạy những phép toán như ma trận thưa, stencil, sắp xếp và rút gọn. Đây là tuyên bố về thiết kế của hãng; hiện chưa có số đo độc lập để xác định mức cải thiện trong từng ứng dụng.
GPU cũng sử dụng NVLink thế hệ thứ 7 để kết nối GPU với GPU trong hệ thống. Với các cụm máy tính chạy mô phỏng lớn, giao tiếp giữa nhiều GPU có thể ảnh hưởng đến thời gian hoàn tất công việc bên cạnh tốc độ tính toán của từng chip. NVIDIA chưa đưa ra thông lượng cụ thể cho triển khai NVLink này, vì vậy chưa thể lượng hóa lợi ích.
GPU này hướng tới vòng lặp mô phỏng của các AI agent
NVIDIA đặt Rubin HPC vào quy trình trong đó các AI agent đề xuất vật liệu, phân tử hoặc thiết kế, sau đó mô phỏng giúp nhà nghiên cứu kiểm tra giả thuyết và chọn bước tiếp theo. Nếu thời gian chờ giữa các vòng mô phỏng giảm, nhóm nghiên cứu có thể sàng lọc nhiều phương án hơn trước khi chuyển sang thí nghiệm hoặc chế tạo mẫu thật.
Giá trị của hướng tiếp cận này phụ thuộc vào cả phần cứng lẫn phần mềm. NVIDIA nhắc tới các thư viện CUDA-X với những thuật toán tối ưu cho mô phỏng và phân tích; việc chúng có phù hợp với từng ứng dụng hay không sẽ cần được kiểm chứng khi hệ thống và phần mềm cụ thể xuất hiện. Vì vậy, tuyên bố về tốc độ khám phá nhanh hơn hiện vẫn là mục tiêu thiết kế, chưa phải kết quả benchmark đã công bố.
Mốc 2028 còn để ngỏ giá và hiệu năng thực tế
Rubin HPC dự kiến có mặt trên các hệ thống vào năm 2028, nên đây chưa phải lựa chọn có thể mua cho máy tính cá nhân. Sản phẩm nhắm tới trung tâm dữ liệu và các hệ thống tính toán hiệu năng cao; mức giá, cấu hình hệ thống, điện năng tiêu thụ và kết quả thử nghiệm vẫn chưa được công bố trong thông tin hiện có.
Với người chơi game, số nhân CUDA của Rubin HPC không phải lý do để chờ thay RTX 5090. Điều đáng theo dõi là cách các nhà cung cấp triển khai GPU này trong hệ thống khoa học và liệu các phép đo thực tế có chứng minh được lợi ích của việc phối hợp tính toán với luân chuyển dữ liệu hay không.