Tóm tắt nhanh
- Bản V4.1-Flash-1017 ra mắt trên website, ứng dụng và API; trọng số được đăng trên Hugging Face và ModelScope theo giấy phép MIT.
- Theo bảng benchmark trên model card Hugging Face, mô hình đạt 77,0 điểm DeepSWE v1.1 Pass@1 khi chạy với mini-swe-v2 harness; Claude Opus 5 đạt 74,0 ở cùng hàng benchmark.
- Hãng mở Search và Fetch API với giá 0,75 USD cho mỗi 1.000 lượt gọi ở từng endpoint; quyền dùng miễn phí qua công cụ server-side dành cho người dùng API kết thúc ngày 31/10/2026.
V4.1-Flash-1017 là bản cập nhật nhỏ, nhưng hãng đặt trọng tâm vào một điểm thực dụng: làm tác vụ lập trình theo chuỗi bằng mô hình agent tiêu tốn ít thời gian và token hơn. Kết quả benchmark trong bảng benchmark có kết quả cạnh tranh ở một số bài coding và agent, song không đủ cơ sở để gọi đây là mô hình vượt trội trên mọi dạng suy luận.
Lợi thế của Flash thể hiện rõ nhất ở một số tác vụ agent
Điểm số cao nhất trong nhóm coding-agent của bảng công bố là 77,0 DeepSWE v1.1 Pass@1. Kết quả này được đo bằng mini-swe-v2 harness và đặt cạnh phiên bản Flash trước đó ở 74,2, GPT-5.6 Sol ở 73,0 cùng Opus 5 ở 74,0. Trên Automation-Bench v1.0.6, mô hình ghi 60,5 điểm, còn Opus 5 là 50,3.
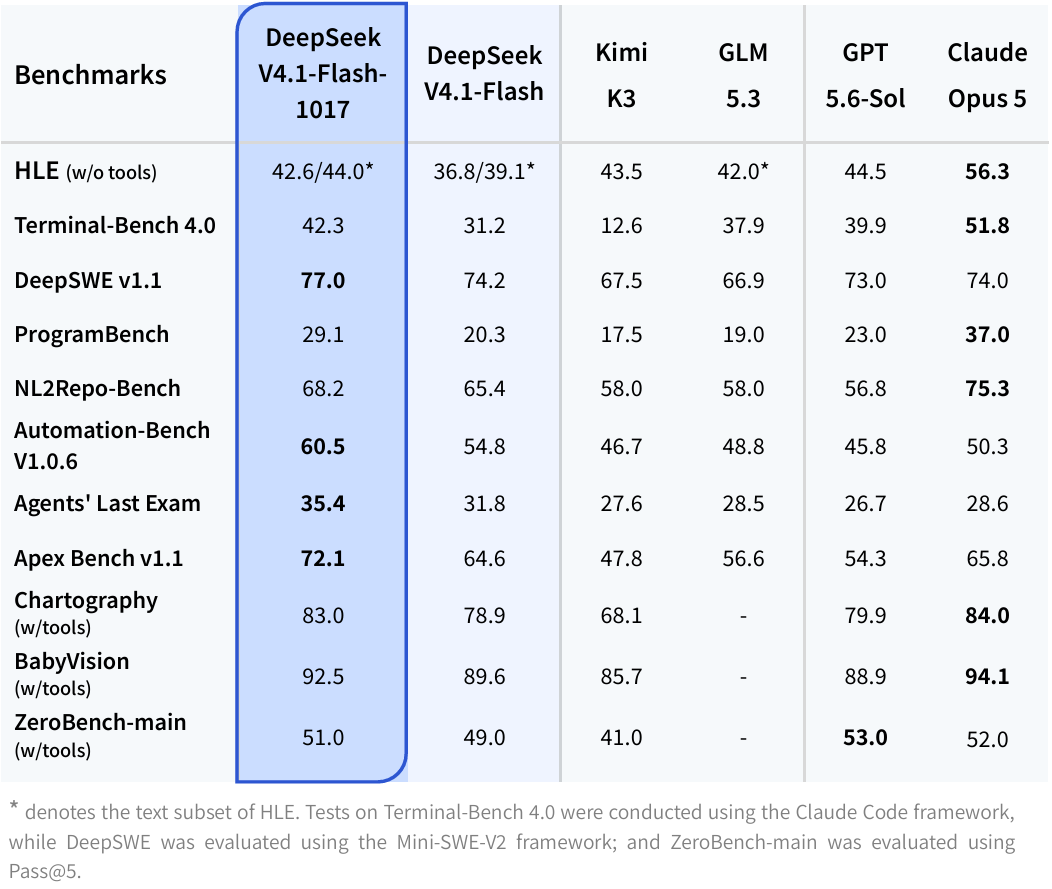
Đó là các kết quả có ý nghĩa khi công việc cần agent đọc yêu cầu, sửa mã, chạy thử rồi tiếp tục xử lý lỗi. Chúng không chứng minh mô hình làm tốt hơn trong mọi tác vụ lập trình, càng không đại diện cho chất lượng phần mềm đưa vào sử dụng nếu thiếu đánh giá trên dự án thực tế.
| Benchmark | V4.1-Flash-1017 | V4.1-Flash | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|
| DeepSWE v1.1 Pass@1 (cao hơn tốt hơn) | 77,0 | 74,2 | 73,0 | 74,0 |
| Terminal-Bench 4.0 (cao hơn tốt hơn) | 42,3 | 31,2 | 39,9 | 51,8 |
| Automation-Bench v1.0.6 (cao hơn tốt hơn) | 60,5 | 54,8 | 45,8 | 50,3 |
| Agents’ Last Exam (cao hơn tốt hơn) | 35,4 | 31,8 | 26,7 | 28,6 |
| Apex Bench v1.1 (cao hơn tốt hơn) | 72,1 | 64,6 | 54,3 | 65,8 |
Số liệu: DeepSeek, model card Hugging Face; đây là benchmark do nhà phát triển công bố.
Bảng cho thấy một bức tranh phân hóa: Flash-1017 vượt Opus 5 ở ba hàng agent/coding nêu trên, nhưng thua ở Terminal-Bench 4.0. Ở Humanity’s Last Exam không dùng công cụ, Opus 5 đạt 56,3 còn Flash-1017 đạt 42,6. Vì thế, tuyên bố hợp lý hơn là bản Flash mới đáng chú ý ở một số quy trình agent, không phải thay thế đồng đều các mô hình lớn hơn.
Ít token có thể hạ chi phí, nhưng con số cần được đọc đúng ngữ cảnh
Hãng mô tả bản cập nhật có đầu ra ngắn hơn và hoàn thành tác vụ nhanh hơn thế hệ trước. Cơ chế hậu huấn luyện dùng học tăng cường với tự phản hồi được giới thiệu nhằm cải thiện quá trình hoàn thành dự án từ đầu đến cuối, từ tạo trò chơi đến dựng mô hình 3D. Đây là mô tả của nhà phát triển; dữ liệu chưa có dữ liệu tách riêng mức đóng góp của kỹ thuật này vào điểm benchmark hay chi phí.
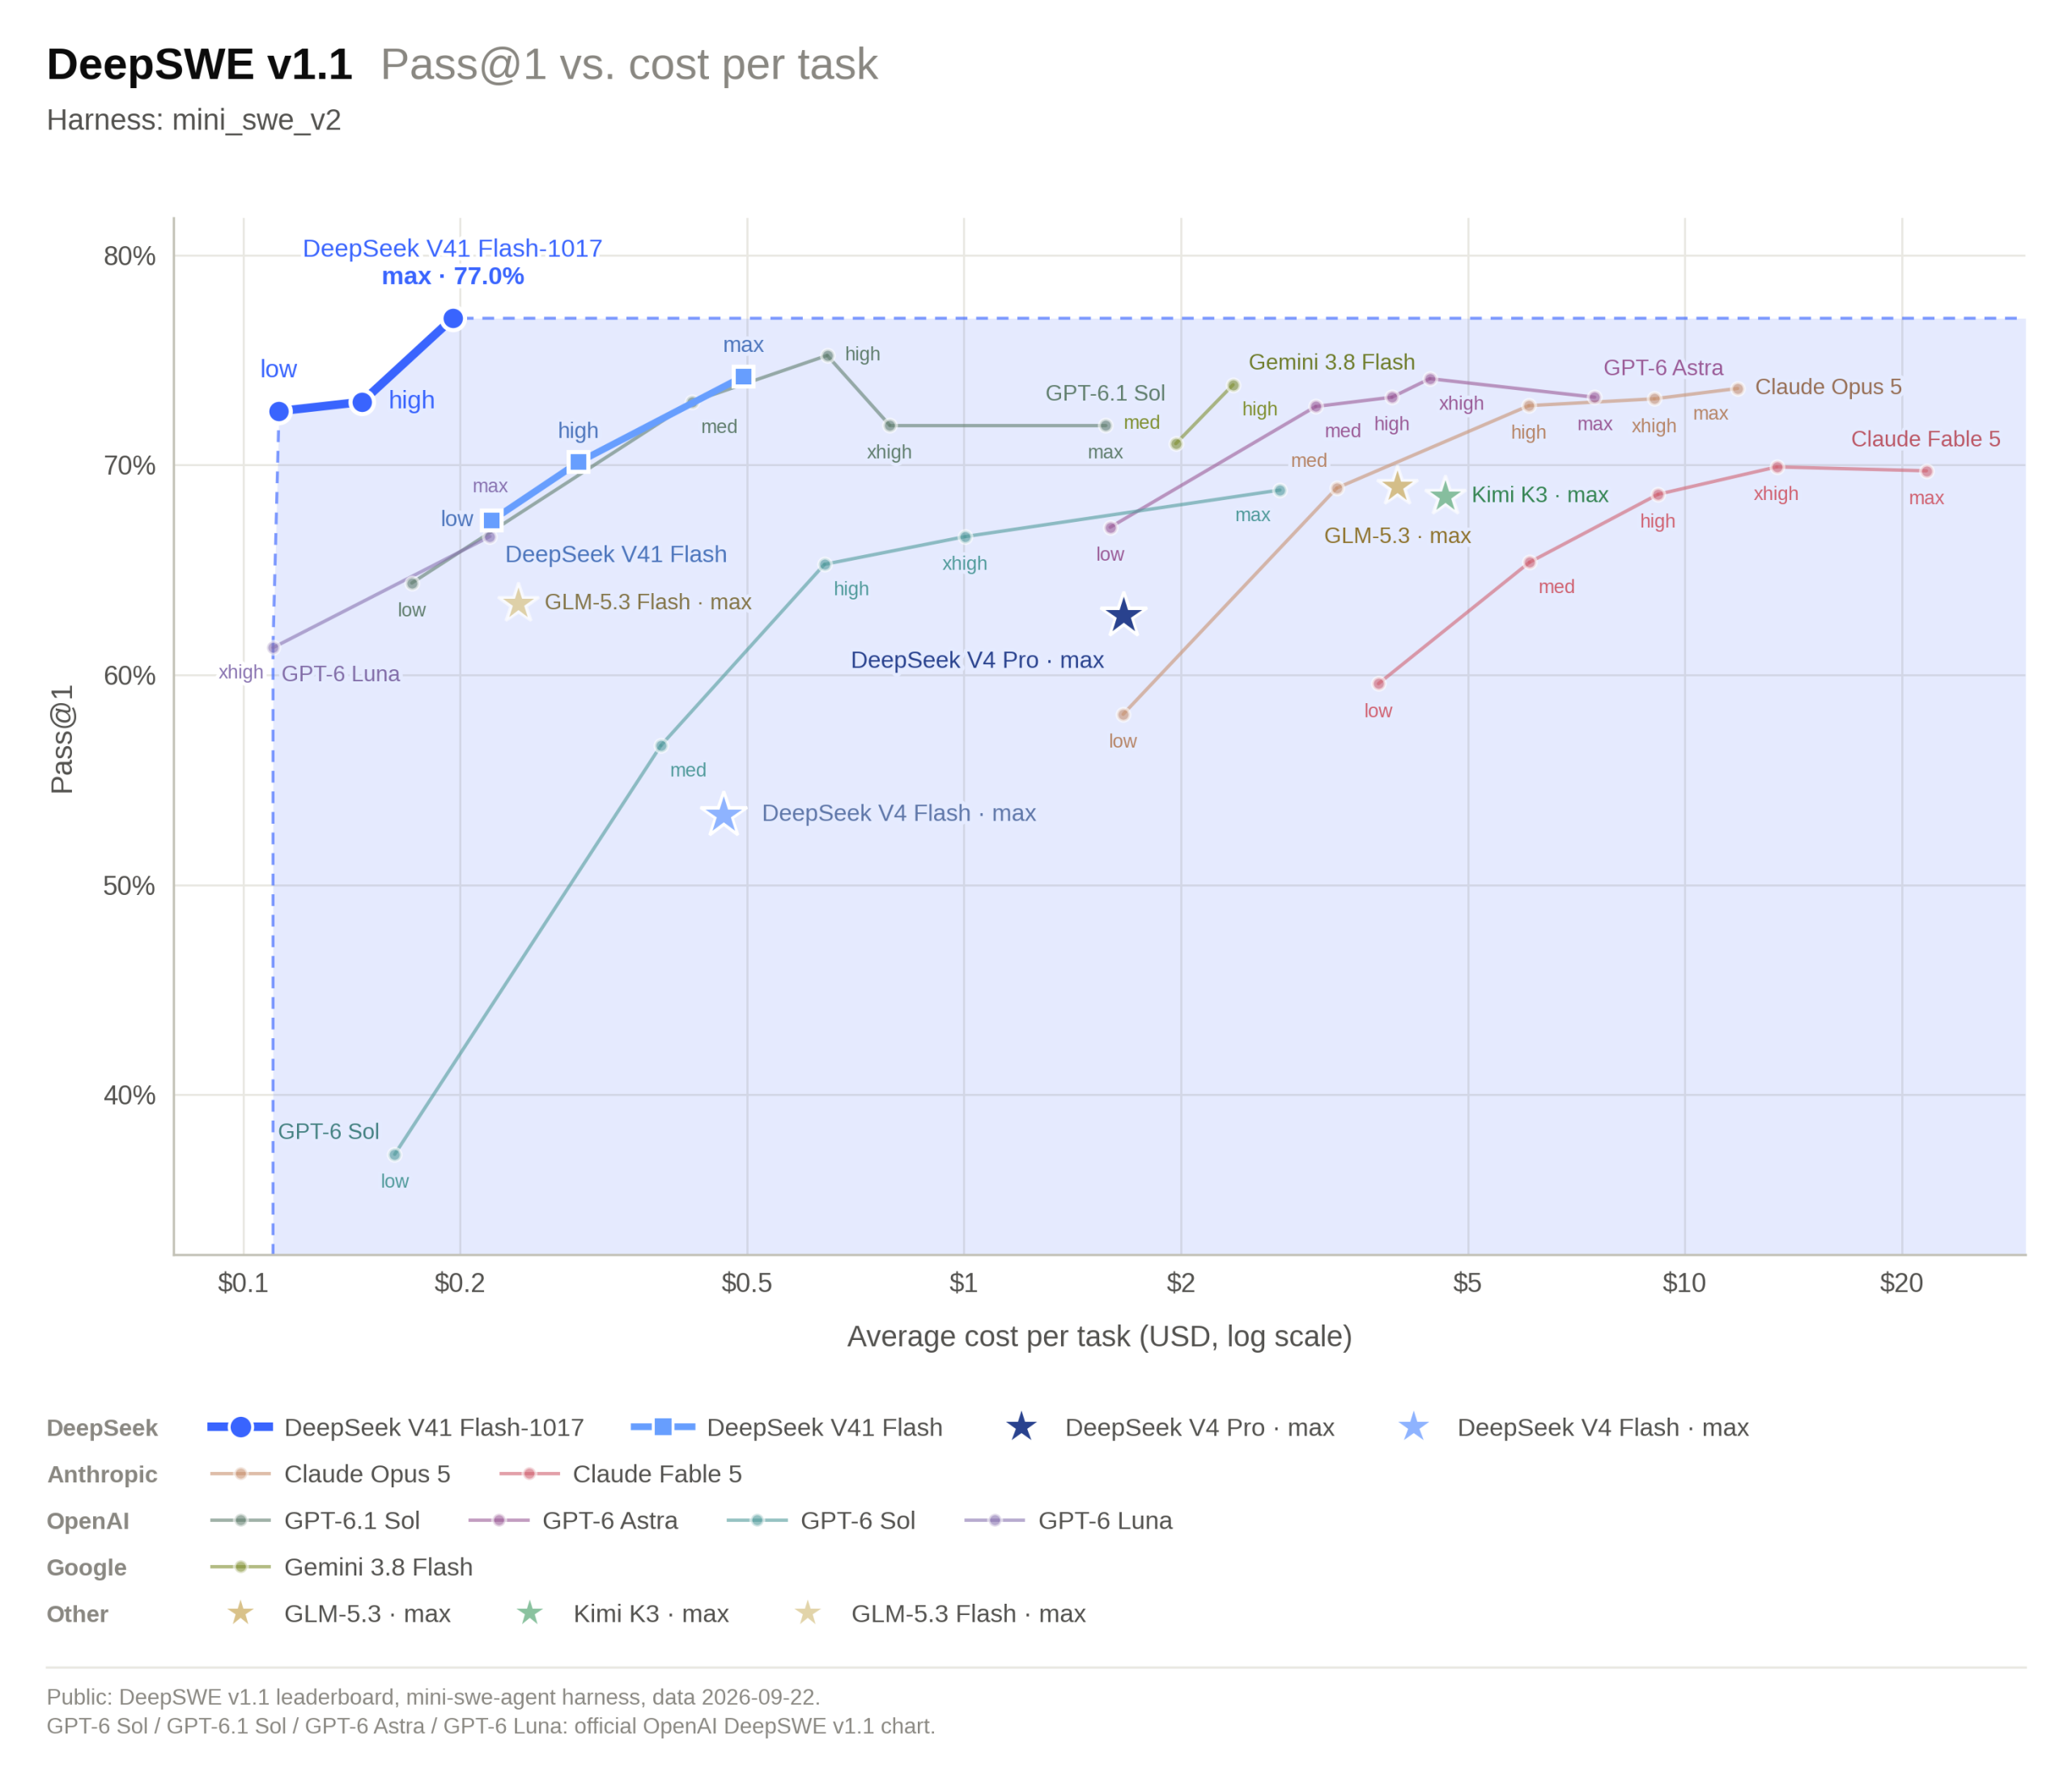
Biểu đồ chi phí DeepSWE công bố cùng bản cập nhật đặt cấu hình đạt khoảng 77% có chi phí trung bình chưa tới 0,20 USD mỗi tác vụ, còn thiết lập thấp ghi trên 72% ở khoảng 0,10 USD. Đây là kết quả trong harness và điều kiện thử nghiệm cụ thể, không nên suy rộng thành giá cố định cho mọi yêu cầu lập trình. Tổng chi phí thực tế còn phụ thuộc độ dài ngữ cảnh, số vòng gọi công cụ và lượng đầu ra.
Với lập trình viên Việt Nam, điểm đáng cân nhắc không chỉ là mức điểm mà là khả năng dự toán chi phí cho agent chạy lặp. Một tác vụ nhỏ vài xu có thể hấp dẫn khi chạy nhiều lần, nhưng nếu agent cần nhiều lượt sửa hoặc kết quả phải kiểm tra thủ công, chi phí và thời gian cuối cùng sẽ khác con số của một lượt benchmark.
Search và Fetch API giảm rào cản thử nghiệm, chưa xóa bài toán vận hành
Hãng cũng mở Search và Fetch API cho nhà phát triển bên ngoài, với giá 0,75 USD/1.000 lượt gọi cho mỗi endpoint. Hãng cho biết lượt gọi thông qua công cụ server-side trong DeepSeek Harness, Claude Code và Codex hiện miễn phí đối với người dùng DeepSeek API; tính phí bắt đầu lúc 16:00 UTC ngày 31/10/2026.
Mức giá công bố giúp nhóm nhỏ dễ tính thử chi phí đưa tìm kiếm web vào agent thay vì phải tự xây dựng ngay một hệ thống retrieval. Tuy vậy, giá mỗi lượt gọi không phản ánh toàn bộ chi phí sản phẩm: ứng dụng còn phải xử lý truy vấn, lọc kết quả, quản lý độ trễ và kiểm tra nguồn mà mô hình dùng để trả lời. Tài liệu hiện tại cũng chưa cung cấp trong package một phép so sánh độc lập về độ phủ tìm kiếm hay chất lượng trích xuất của API mới.
Trọng số V4.1-Flash-1017 được phát hành theo MIT License, nhưng khả năng tự chạy tại chỗ vẫn là chuyện khác với việc tải một file nhỏ về máy cá nhân: model card liệt kê tổng cộng khoảng 763 tỷ tham số trong nhiều định dạng trọng số. Với phần lớn lập trình viên, dùng API hoặc hạ tầng suy luận có sẵn thực tế hơn; giấy phép mở rộng quyền sử dụng phần mềm, chứ không làm mất yêu cầu phần cứng và chi phí phục vụ mô hình.
Mô hình hiện có trên website, ứng dụng và API và dưới dạng trọng số trên Hugging Face, ModelScope. Điều còn cần kiểm chứng là liệu lợi thế chi phí trên các benchmark này có giữ được khi nhóm phát triển chạy agent trên mã nguồn, công cụ và tác vụ thường ngày của họ hay không.
Nguồn tham khảo: DeepSeek API Docs; DeepSeek trên Hugging Face; The Decoder