Tóm tắt nhanh
- M3.1 Flash có 428 tỷ tham số tổng, trong đó 23 tỷ được kích hoạt cho mỗi token.
- Hãng báo cáo mức giảm 70% chi phí tác vụ agentic và tốc độ suy luận trực tuyến gần gấp 3 lần so với M3.
- MSA chọn một phần nhỏ các block KV-cache để tính attention, thay vì xử lý toàn bộ ngữ cảnh dài.
- Dịch vụ API có giá 0,15 USD/triệu token đầu vào và 0,60 USD/triệu token đầu ra; đây không phải thiết bị bán lẻ.
M3.1 Flash cho thấy năng lực của một phòng thí nghiệm AI không thể đo chỉ bằng số GPU. Mô hình MoE kích hoạt một phần tham số cho mỗi token, trong khi MSA được thiết kế để giảm lượng tính toán attention trên ngữ cảnh dài.
Quy mô tham số không nói hết chi phí suy luận
Trong mô hình Mixture of Experts (MoE), toàn bộ tham số không nhất thiết cùng hoạt động cho mỗi token. M3.1 Flash được công bố với 428 tỷ tham số tổng và 23 tỷ tham số kích hoạt. Con số đầu phản ánh quy mô phần trọng số của mô hình; con số sau gần hơn với lượng tham số được dùng trong một lượt xử lý, dù chưa đủ để tự suy ra tổng chi phí vận hành vì còn phụ thuộc bộ nhớ, băng thông, batching và cách triển khai.
Đó là lý do so số GPU giữa các phòng thí nghiệm cần được đọc thận trọng. Các ước tính được nguồn phân tích dẫn lại đặt hãng ở khoảng 70.000 GPU tương đương H100, DeepSeek khoảng 47.000 trong khi cùng bài nêu quy mô lớn hơn đáng kể cho OpenAI. Đây không phải phép đo trực tiếp hiệu năng của M3.1 Flash, cũng không cho biết phần cứng được phân bổ thế nào giữa huấn luyện và phục vụ mô hình. Quy mô cụm chỉ là một đầu vào; kiến trúc và hiệu suất sử dụng cụm mới quyết định mỗi lượt suy luận tốn bao nhiêu.
MSA giảm lượng KV-cache phải đưa vào attention
Khi mô hình đọc chuỗi dài, KV-cache lưu các biểu diễn đã tạo để dùng lại ở những token tiếp theo. Nếu attention phải xét toàn bộ lịch sử ở mỗi bước, phần dữ liệu cần truy cập và tính toán tăng lên, gây áp lực lên bộ nhớ và tốc độ. MSA chia KV-cache thành các block, chấm điểm mức liên quan với chi phí thấp rồi chỉ đưa khoảng 6–7% block vào phép tính đầy đủ, theo mô tả kỹ thuật.
Cách làm này không loại bỏ giới hạn của ngữ cảnh dài; nó đổi bài toán từ “đọc mọi vị trí” sang “chọn vị trí có khả năng hữu ích”. Nếu bước chọn block bỏ sót thông tin quan trọng, chất lượng câu trả lời có thể bị ảnh hưởng. Vì vậy, tuyên bố giảm chi phí attention xuống khoảng 1/20 cần được hiểu trong phạm vi cơ chế và điều kiện hãng mô tả, không phải cam kết mọi truy vấn sẽ rẻ hơn đúng 20 lần.
Các kernel GPU tùy biến được cho là giúp tăng tốc prefill 9 lần và decode 15 lần ở ngữ cảnh dài. Đây là những con số về từng giai đoạn xử lý được nêu trong bài phân tích kỹ thuật, không nên gộp thành mức tăng tốc chung cho mọi yêu cầu. Với người dùng API, yếu tố cần nhìn là độ trễ đầu-cuối và chi phí trên tác vụ hoàn thành, chứ không chỉ tốc độ token trong một điều kiện thử nghiệm.
Giá API thấp giúp agent chạy nhiều bước dễ dự toán hơn
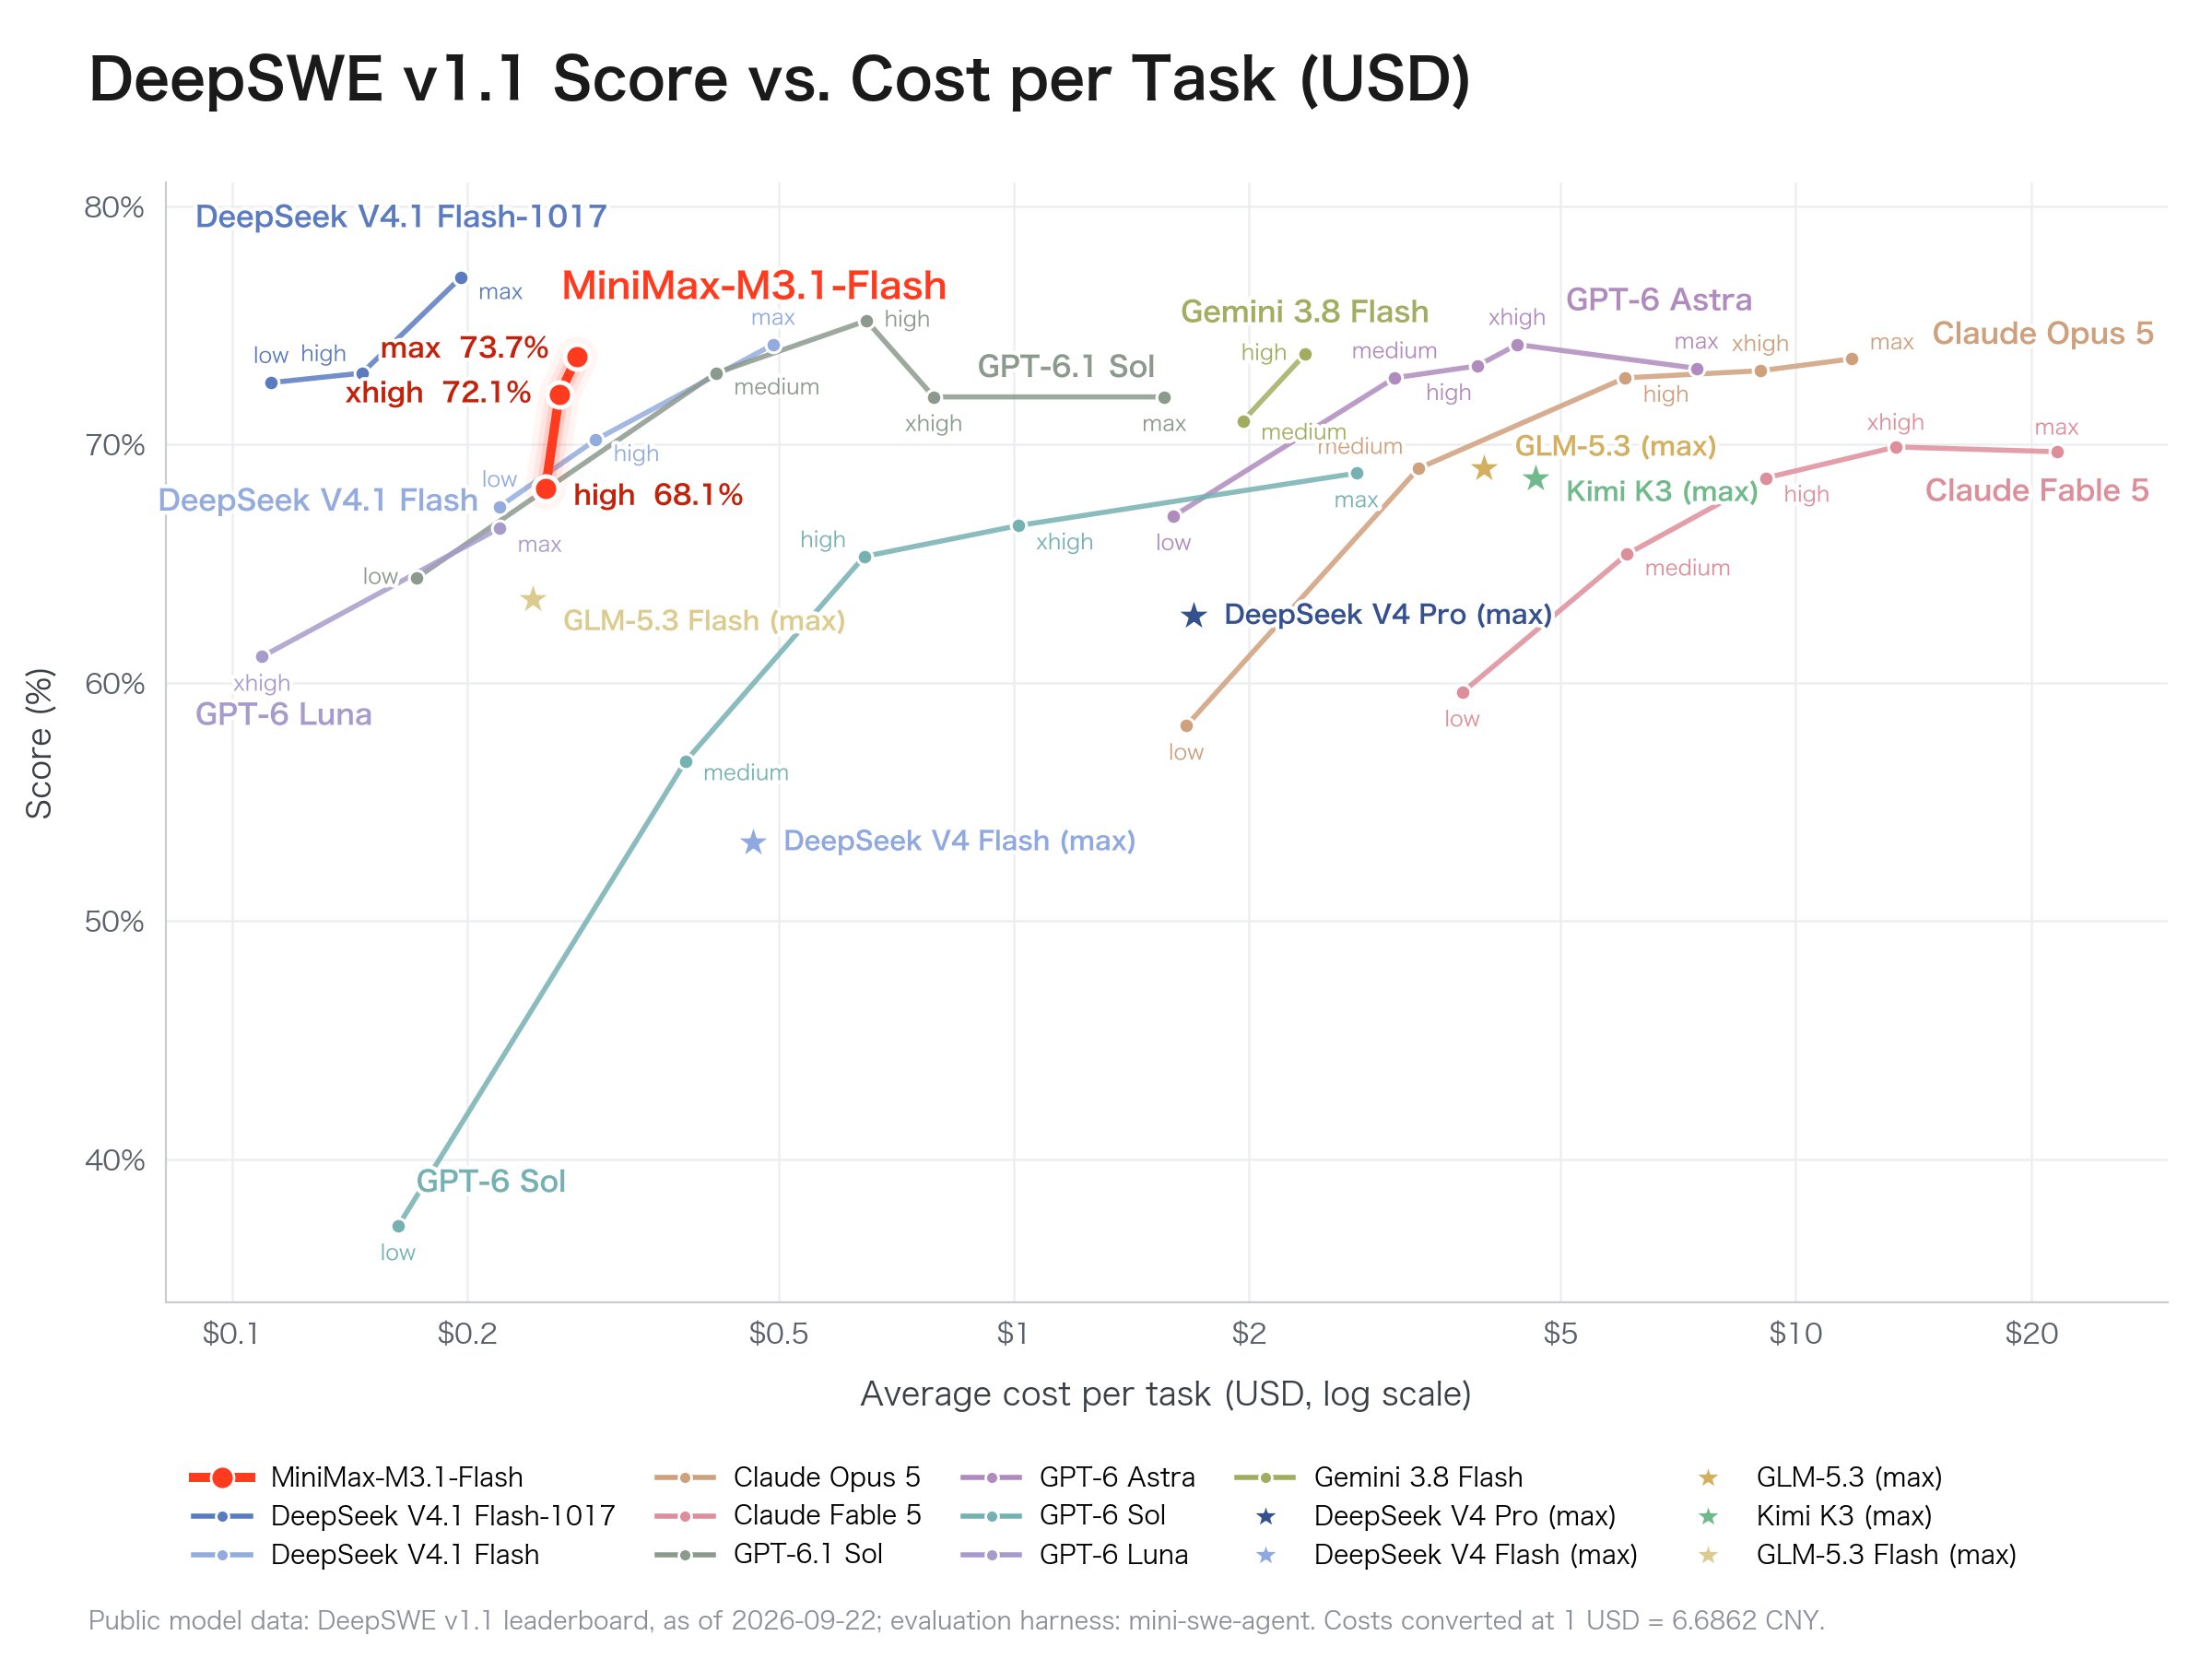
Bảng giá M3.1 Flash ở mức 0,15 USD cho một triệu token đầu vào, 0,60 USD cho một triệu token đầu ra và 0,015 USD cho một triệu token đầu vào đã lưu cache. Hãng cũng tuyên bố chi phí sử dụng cho tác vụ agentic thấp hơn 70% so với M3 và suy luận trực tuyến nhanh gần 3 lần so với model tiền nhiệm M3, dựa trên phép đo nội bộ của hãng.
Với agent, một yêu cầu có thể kéo theo nhiều lượt gọi công cụ, đọc tài liệu và kiểm tra kết quả. Giá mỗi token thấp vì thế có thể giảm chi phí thử nghiệm và mở rộng quy mô sử dụng. Nhưng chi phí thực tế vẫn phụ thuộc lượng token đầu vào/đầu ra, tỷ lệ cache, số lần agent phải gọi lại mô hình và chất lượng đầu ra. Model rẻ hơn nhưng cần nhiều vòng sửa chưa chắc rẻ hơn trên mỗi công việc hoàn tất.
M3.1 Flash đạt 73,7% trên DeepSWE v1.1 và 61,7 điểm trên OSWorld V2 theo số liệu MiniMax công bố. Đây là kết quả tự báo cáo, hữu ích để hiểu nhóm tác vụ hãng nhắm tới nhưng chưa đủ để kết luận về thứ hạng thực tế nếu thiếu phép đối chiếu độc lập cùng điều kiện.
Người dùng Việt Nam có thể thử qua API, không phải chờ hàng bán lẻ
M3.1 Flash là mô hình và dịch vụ API, không phải sản phẩm phần cứng có giá bán tại cửa hàng Việt Nam. Người phát triển trong nước có thể cân nhắc chi phí theo bảng giá USD của hãng, nhưng cần kiểm tra thêm phương thức thanh toán, điều khoản dữ liệu, giới hạn tốc độ và khả năng truy cập dịch vụ trước khi đưa vào quy trình sản xuất.
Điểm cạnh tranh đáng theo dõi không đơn thuần là M3.1 Flash có vượt một mô hình khác ở một benchmark hay không. Nếu mô hình giữ được chất lượng trong tác vụ nhiều bước với chi phí thấp, nhà phát triển có thêm lựa chọn để chạy agent thường xuyên. Còn nếu chất lượng giảm khiến phải kiểm tra thủ công hoặc gọi lại nhiều lần, lợi thế giá trên bảng API sẽ thu hẹp.
Distillation chưa giải thích được toàn bộ tiến bộ
Ước tính về số GPU của hãng và DeepSeek không chứng minh hai công ty không dùng distillation, cũng không xác định nguồn gốc năng lực của từng mô hình. Distillation có thể đóng góp vào năng lực mô hình, nhưng dữ liệu công khai hiện có không đủ để xác định nó giữ vai trò chính hay giải thích hết tiến bộ quan sát được.
Trường hợp M3.1 Flash cho thấy một hướng giải thích cụ thể hơn: mô hình thưa, attention chọn lọc và tối ưu kernel có thể làm giảm chi phí phục vụ mà không cần mọi thành phần hoạt động ở mỗi token. Nhưng hiệu quả cuối cùng vẫn cần được kiểm chứng bằng các phép đo độc lập trên cùng bộ tác vụ. Unite.AI đưa tin OpenRouter cho biết trọng số dự kiến phát hành ngày 23/10/2026, còn thông báo chính thức chỉ nói chúng sẽ ra mắt sau.
Nguồn tham khảo: hãng, nguồn phân tích, Unite.AI.