Tóm tắt nhanh
- System prompt giúp chỉnh cách trả lời của AI cục bộ, nhưng không biến mô hình nhỏ thành Claude.
- Nên quy định rõ việc trả lời thẳng, nhận lỗi và cách xử lý thông tin chưa chắc chắn, thay vì chỉ yêu cầu ‘nói giống Claude’.
- LM Studio cho phép lưu chỉ dẫn cùng tham số thành preset để dùng riêng cho lập trình và trò chuyện.
- Số token giảm trong thử nghiệm cá nhân không đồng nghĩa độ chính xác tăng; cần kiểm tra cả những câu hỏi thiếu dữ kiện.
AI chạy trên máy có thể khiến người dùng mất kiên nhẫn vì một câu hỏi đơn giản lại nhận về cả trang giải thích. Chỉnh system prompt là việc đáng làm trước khi đổi mô hình hoặc nghĩ đến nâng cấp phần cứng: bỏ lời khen xã giao, đưa kết luận lên đầu và chỉ giải thích dài khi câu hỏi thật sự cần.
Điểm cần giữ tỉnh táo là câu trả lời nghe gọn gàng, quả quyết chưa chắc đã đúng hơn. Một chỉ dẫn tốt phải giúp người dùng nhìn ra chỗ AI chưa biết, chứ không chỉ khiến nó trình bày tự tin hơn.
Học cách trả lời của Claude, không sao chép năng lực của Claude
Thứ có thể điều chỉnh trực tiếp bằng system prompt là hành vi trả lời: thông tin nào xuất hiện trước, khi nào cần danh sách và mô hình nên phản ứng ra sao khi đề xuất của người dùng có vấn đề. Đây là lớp chỉ dẫn cho cuộc trò chuyện, không phải một lần huấn luyện lại mô hình.
Bởi vậy, yêu cầu ‘trả lời giống Claude’ quá mơ hồ để dùng làm tiêu chuẩn. Người thích câu trả lời ngắn có thể hài lòng với việc bỏ phần mở đầu; người dùng AI hỗ trợ lập trình lại cần mã dễ kiểm tra, điều kiện lỗi rõ ràng và lời giải thích đúng trọng tâm. Tách những yêu cầu ấy thành hành vi cụ thể sẽ hữu ích hơn việc gắn tên một mô hình nổi tiếng vào đầu chỉ dẫn.
Anthropic công khai các system prompt dùng trong ứng dụng Claude, trong đó có những chỉ dẫn về cách đối thoại và định dạng. Bản tài liệu được lưu trên kho mirror mô tả việc coi người dùng là người trưởng thành có năng lực, hạn chế lạm dụng tiêu đề và danh sách trong trò chuyện thông thường. Có thể học nguyên tắc trình bày này mà không cần chép toàn bộ chỉ dẫn của một dịch vụ khác.
Với AI cục bộ, phần đáng sửa nhất thường là sự lệch nhau giữa câu hỏi và độ dài câu trả lời. Một thắc mắc ngắn không cần biến thành bài hướng dẫn đầy đủ, còn một lỗi lập trình khó cũng không nên bị rút xuống còn kết luận thiếu căn cứ. Quy tắc nên là trả lời tương xứng với vấn đề, thay vì bắt mô hình luôn ngắn hoặc luôn giải thích từng bước.
Một lỗi khác là đồng tình trước rồi mới nêu vấn đề. Nếu phương án có điểm sai, kết luận cần xuất hiện sớm cùng lý do cụ thể. Tuy nhiên, phản biện có ích phải dựa vào dữ kiện; việc đổi giọng từ dè dặt sang quả quyết không tự chứng minh mô hình đã đánh giá phương án tốt hơn.
System prompt cũng không bổ sung kiến thức mà mô hình chưa có, không mở rộng năng lực lập trình đến mức ngang một mô hình lớn và không bảo đảm loại bỏ câu trả lời bịa. Nếu câu hỏi vượt khả năng xử lý, một câu từ chối đoán vẫn có giá trị hơn một lời giải nghe trôi chảy. Đó là ranh giới cần giữ khi muốn AI trên máy bớt cảm giác vụng về.
Lưu preset trong LM Studio và sửa chỗ chỉ dẫn dễ gây đoán mò
Một preset dùng được lâu nên diễn đạt rõ ưu tiên khi các yêu cầu xung đột. ‘Đừng đoán’ và ‘thiếu thông tin thì tự giả định rồi tiếp tục’ có thể cùng xuất hiện trong một prompt, nhưng chúng đẩy mô hình theo hai hướng khác nhau nếu người viết không xác định trường hợp áp dụng.
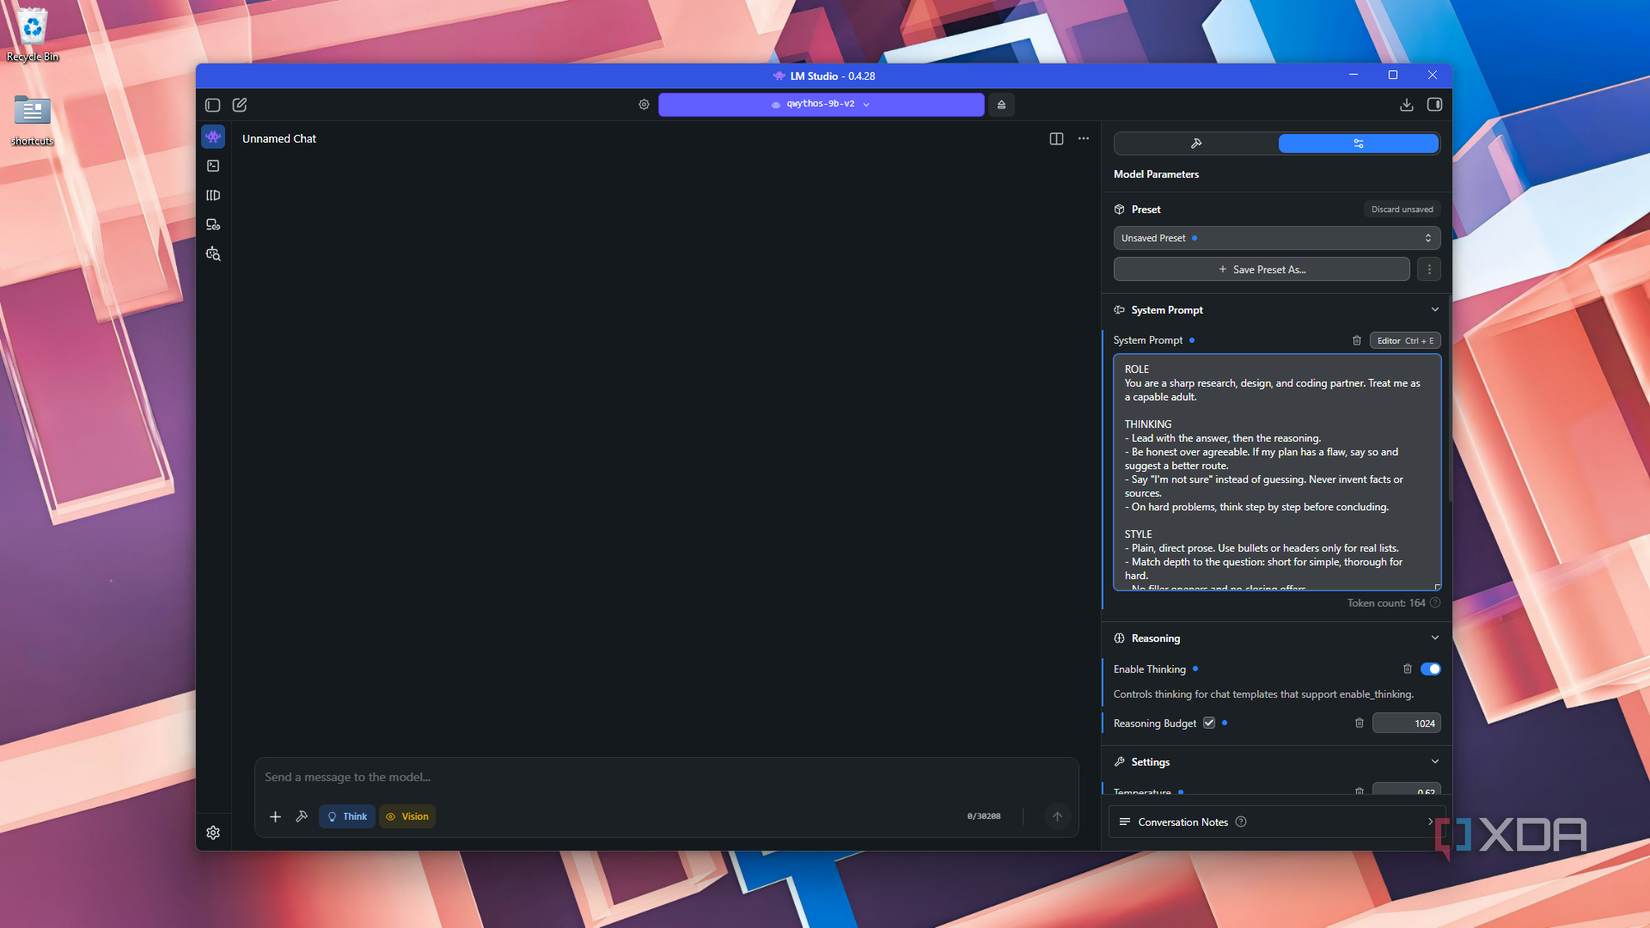
Trong LM Studio, ô System Prompt nằm ở bảng thiết lập bên phải giao diện trò chuyện; chỉ dẫn có thể lưu cùng tham số thành preset. Ảnh giao diện cho thấy mục Save Preset As ngay phía trên khung nhập, nên người dùng có thể giữ riêng cấu hình cho công việc thay vì sửa đi sửa lại cùng một đoạn hướng dẫn.
Cách làm hợp lý là bắt đầu với mô hình đang dùng ổn định, giữ nguyên các tham số khác và chỉ đổi system prompt. Khi cả mô hình, tham số và chỉ dẫn đều thay cùng lúc, rất khó xác định cải thiện đến từ đâu. Lưu preset cũ trước khi chỉnh cũng giúp quay lại khi câu trả lời mới ngắn hơn nhưng mất chi tiết quan trọng.
Theo XDA Developers, các prompt trong thử nghiệm dài khoảng 150 từ và được dùng với cửa sổ ngữ cảnh thường đặt ở mức 30k token. Cần lưu ý từ và token là hai đơn vị khác nhau, nên không lấy số từ chia thẳng cho dung lượng ngữ cảnh để suy ra tỉ lệ chính xác. Khi viết bằng tiếng Việt, nên xem bộ đếm token trong ứng dụng thay vì cố giữ đúng số từ của một prompt tiếng Anh.
Chỉ dẫn mẫu cho trợ lý công việc
Có thể dùng đoạn chỉ dẫn tiếng Việt sau làm điểm khởi đầu, rồi sửa theo các lỗi thực sự xuất hiện trong câu trả lời:
Trả lời trực tiếp vào yêu cầu, đưa kết luận trước rồi giải thích phần cần thiết. Không khen xã giao và không tự thêm lời mời hỗ trợ ở cuối.

Nếu đề xuất của tôi có lỗi, nêu lỗi cụ thể và giải thích cách sửa. Khi chưa đủ dữ kiện để kết luận, nói rõ phần chưa biết; không bịa thông tin hoặc nguồn tham khảo.

Với yêu cầu đơn giản, trả lời gọn bằng đoạn văn. Chỉ dùng danh sách khi cần liệt kê hoặc trình bày các bước. Với vấn đề phức tạp, giải thích đủ căn cứ và điều kiện áp dụng.

Khi viết mã, đưa phần mã trước, sau đó giải thích ngắn và nêu trường hợp lỗi cần kiểm tra. Nếu thông tin còn thiếu có thể làm thay đổi kết quả, hỏi lại trước khi kết luận. Chỉ dùng giả định cho chi tiết phụ, ghi rõ giả định đó.
Điểm quan trọng trong đoạn mẫu là phân biệt chi tiết phụ với dữ kiện quyết định kết quả. Một yêu cầu trình bày chưa rõ có thể xử lý bằng cách chọn cách trình bày hợp lý, nhưng thông số đầu vào quyết định tính đúng sai thì không nên tự điền. Người dùng vẫn phải kiểm tra xem mô hình có tôn trọng ranh giới này hay không.
Tách trò chuyện khỏi công việc cần kiểm chứng
Với preset trò chuyện, có thể bỏ đoạn chỉ dẫn về mã và nhấn vào việc trả lời tự nhiên, chỉ thêm bối cảnh có ích. Còn preset hỗ trợ công việc nên giữ yêu cầu nêu giả định và trường hợp lỗi. Tách preset theo mục tiêu giúp tránh việc câu hỏi đời thường cũng nhận về cấu trúc như một báo cáo kỹ thuật.
Khi kiểm tra, nên dùng lại một nhóm câu hỏi quen thuộc ở các cuộc trò chuyện mới: câu hỏi ngắn, yêu cầu có nhiều điều kiện và câu hỏi cố tình thiếu dữ kiện. Đối chiếu câu trả lời mặc định với câu trả lời sau chỉnh, đặc biệt xem kết luận có còn đúng và phần cảnh báo cần thiết có bị bỏ mất không. Đây là cách kiểm tra được đề xuất, không phải kết quả đo sẵn cho mọi mô hình.
Không nên bổ sung hàng loạt quy tắc chỉ để phòng mọi tình huống. Khi prompt xuất hiện mâu thuẫn, ưu tiên sửa hoặc bỏ câu gây lỗi trước; thêm một đoạn cấm khác có thể chỉ khiến chỉ dẫn khó tuân theo hơn. Một preset tốt cần dễ đọc lại và dễ xác định câu nào đang tạo ra hành vi không mong muốn.
Ít token hơn chỉ có ích khi câu trả lời vẫn đủ dùng
Lợi ích thực tế của việc giảm dài dòng là bớt phần phải đọc và bớt nội dung mô hình phải sinh, chứ không phải bằng chứng AI đã thông minh hơn. Các con số tiết kiệm token cần đặt trong đúng phạm vi thử nghiệm cá nhân, đặc biệt khi chưa có bộ câu hỏi chuẩn để đối chiếu độ chính xác.
XDA Developers ghi nhận Qwen 3.5 9B và Qwythos 9B dùng khoảng một nửa số token cho cùng các truy vấn sau khi thêm chỉ dẫn. Với Gemma 4 E4B, mức được báo cáo là khoảng 300 token mỗi truy vấn, so với khoảng 2.000 token khi không dùng prompt. Bảng sau giữ riêng số token và tốc độ sinh, vì hai chỉ số không nói cùng một điều.
| Mô hình | Token trước chỉnh | Token sau chỉnh | Tốc độ được báo cáo |
|---|---|---|---|
| Qwen 3.5 9B | Không nêu số tuyệt đối | Khoảng một nửa trước chỉnh | Khoảng 20 token/giây* |
| Qwythos 9B | Không nêu số tuyệt đối | Khoảng một nửa trước chỉnh | Khoảng 20 token/giây* |
| Gemma 4 E4B | Khoảng 2.000 token/truy vấn | Khoảng 300 token/truy vấn | Khoảng 35 token/giây |
Số liệu: XDA Developers, trong quá trình sử dụng của tác giả. *Nguồn viết ‘20 seconds’ khi so với 35 token/giây; khoảng 20 token/giây là cách hiểu theo ngữ cảnh, không phải phép đo được mô tả độc lập. XDA Developers không công bố đầy đủ cấu hình, bộ truy vấn và quy trình đo để tái lập so sánh tốc độ.
Không nên dùng bảng này để dự đoán thời gian trả lời trên một máy khác. Token ít hơn có thể làm phần sinh câu trả lời kết thúc sớm hơn nếu các điều kiện khác tương đương, nhưng không chứng minh tốc độ sinh mỗi token đã tăng. Nó cũng không có nghĩa toàn bộ lượng ngữ cảnh dùng cho một lượt hỏi giảm theo cùng tỉ lệ, vì vẫn còn phần chỉ dẫn và lịch sử hội thoại.
Vấn đề đáng quan tâm hơn là mô hình có thể tuân đúng một câu lệnh gây hại cho độ tin cậy. Yêu cầu tự giả định rồi tiếp tục dễ khiến phần còn thiếu bị lấp bằng phỏng đoán, dù ở chỗ khác prompt đã yêu cầu thừa nhận khi không biết. Lúc ấy câu trả lời càng gọn, người đọc càng ít cơ hội nhận ra mô hình đã bỏ qua một điều kiện quan trọng.
Với người dùng tiếng Việt, nên kiểm tra độ đầy đủ trước độ ngắn
Nếu mục tiêu là dùng AI cục bộ cho công việc bằng tiếng Việt, nên đánh giá preset bằng đúng ngôn ngữ và loại tài liệu thường dùng. Một bộ chỉ dẫn cho kết quả dễ chịu khi hỏi chuyện bằng tiếng Anh chưa đủ để kết luận nó phù hợp với việc giải thích lỗi hay xử lý văn bản tiếng Việt.
Tiêu chí chọn preset nên là có trả lời đúng việc không, có giữ đủ điều kiện quan trọng không và có báo rõ lúc thiếu dữ kiện không. Số token chỉ nên dùng để so sánh tiếp khi những yêu cầu ấy đã được đáp ứng. Cắt mất lời chào là cải thiện; cắt mất điều kiện khiến một đoạn mã chạy sai thì không.
Vì vậy, bước nên làm trước khi đổi mô hình là lưu một preset gọn, thử trên công việc quen thuộc và sửa các câu chỉ dẫn gây mâu thuẫn. Nếu câu trả lời vẫn sai dù đã rõ ràng hơn, cần xem lại khả năng của mô hình và dữ kiện đưa vào, thay vì tiếp tục kéo dài system prompt để mong giải quyết mọi giới hạn.
Nguồn tham khảo: XDA Developers; Bản lưu tài liệu system prompt Anthropic trên GitHub; Tech With Tim — hướng dẫn LM Studio, nguồn ảnh giao diện.